
Ollama 下载安装:不想把资料传到别人服务器?在自己电脑上跑一个
Ollama 是本地大模型的运行环境,免费开源、没有账号体系。装好之后一条命令就能把开源模型拉下来跑,不联网也能对话,内容不上传。它对硬件的要求取决于你跑多大的模型——小模型 8G 内存就能转,大模型得显卡显存撑得住。电脑配置一般的话,先挑小的试。
一、Ollama 下载安装教程:它是干什么的#
在线大模型有几个绕不开的限制:要联网、要账号、免费额度有限、敏感内容不敢往里贴。本地跑模型把这几条全解决了——模型文件在你硬盘上,推理在你显卡上,断网照用,说什么都不出机器。
但本地跑模型本来是件麻烦事。要装 Python 环境、装推理框架、手动转模型格式、写启动脚本,光是让它在显卡上跑起来就能劝退大部分人。
Ollama 把这些步骤收进了一个安装包。 装完之后:
ollama run 模型名模型会自动下载、自动加载、自动匹配你的显卡,下完直接进对话界面。这是它跟其他本地部署方案最大的区别——不用配环境。
它不能干什么,得先说清楚:
| 期待 | 现实 |
|---|---|
| 追上 GPT、Claude 的水平 | 追不上。同参数量的开源模型比闭源旗舰差一截 |
| 笔记本上跑满血大模型 | 跑不动。显存决定上限,8G 显存最多舒服跑 7B-8B |
| 替代在线服务 | 替代不了。它适合「不能联网」「不能外传」的场景 |
什么时候值得装? 处理不方便外传的材料(合同、内部文档、病历)、断网环境要用、想长期无限制地做批量处理、纯粹想试试本地模型什么水平。
二、下载#
三、安装步骤#
绿色版不用安装,解压两层,配一下 PATH 就能跑。
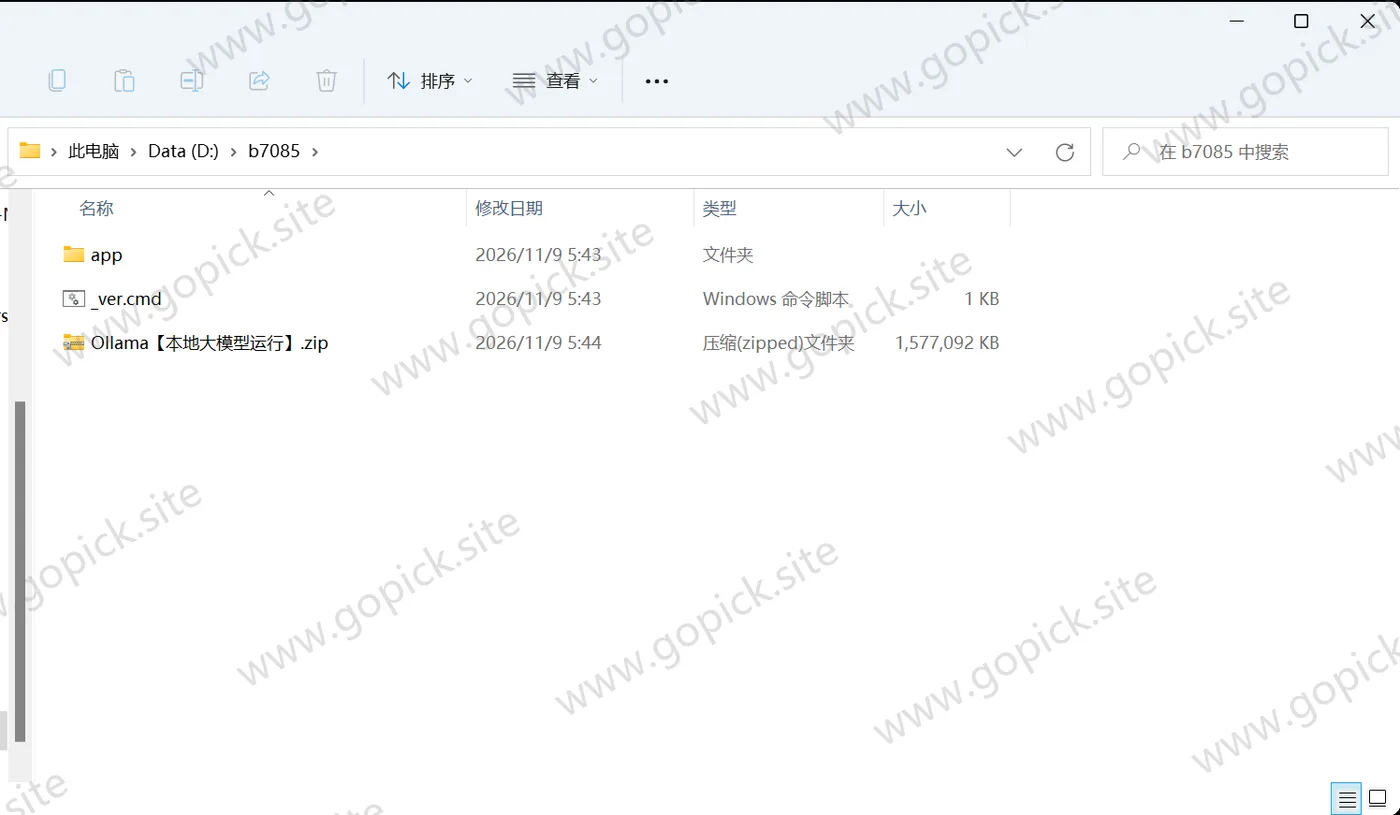
- 解压外层
Ollama【本地大模型运行】.zip(约 1.54GB),里面是ollama-windows-amd64.zip, - 把内层 zip 解压到一个固定目录,比如
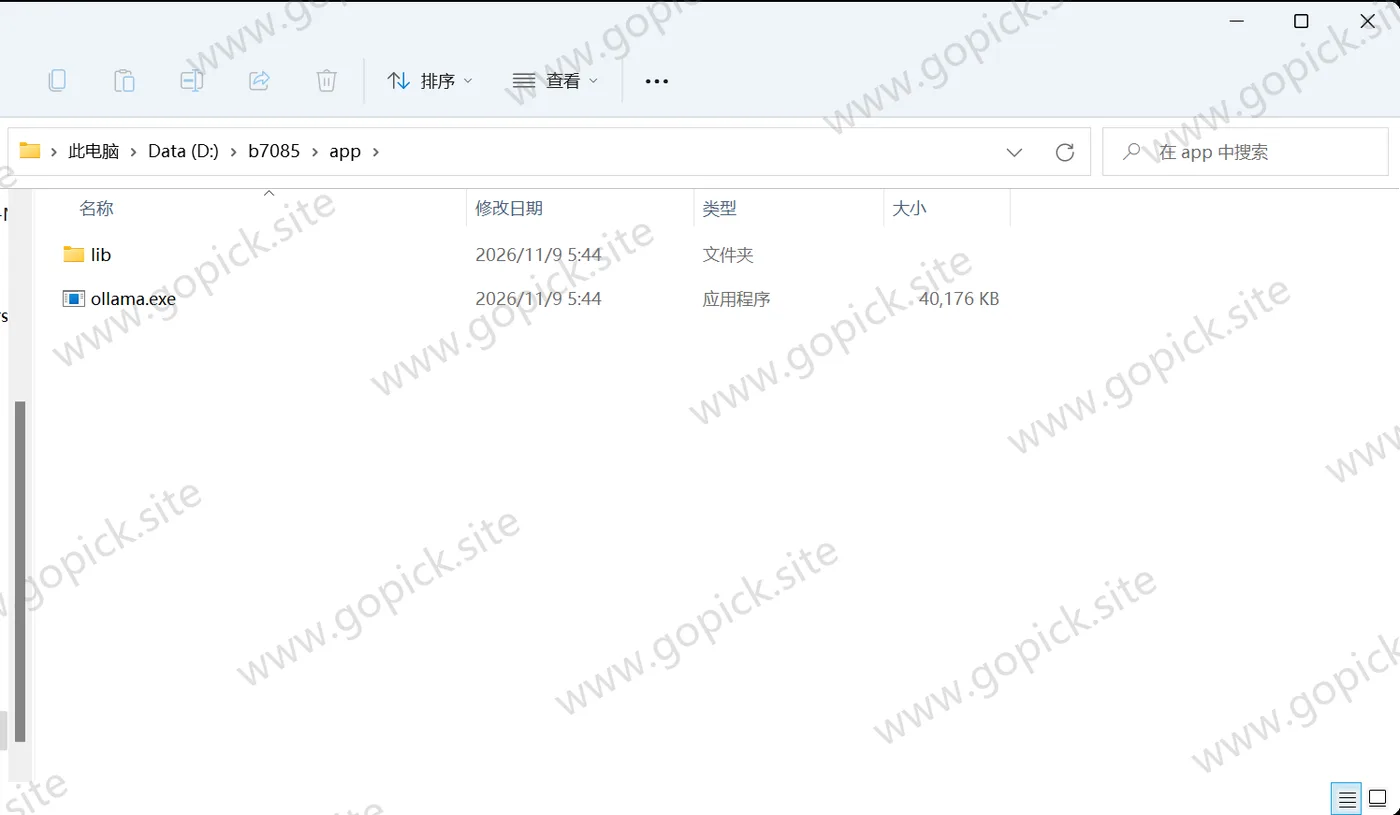
D:\Tools\ollama。ollama.exe和 lib 文件夹就在最上层:
- 把
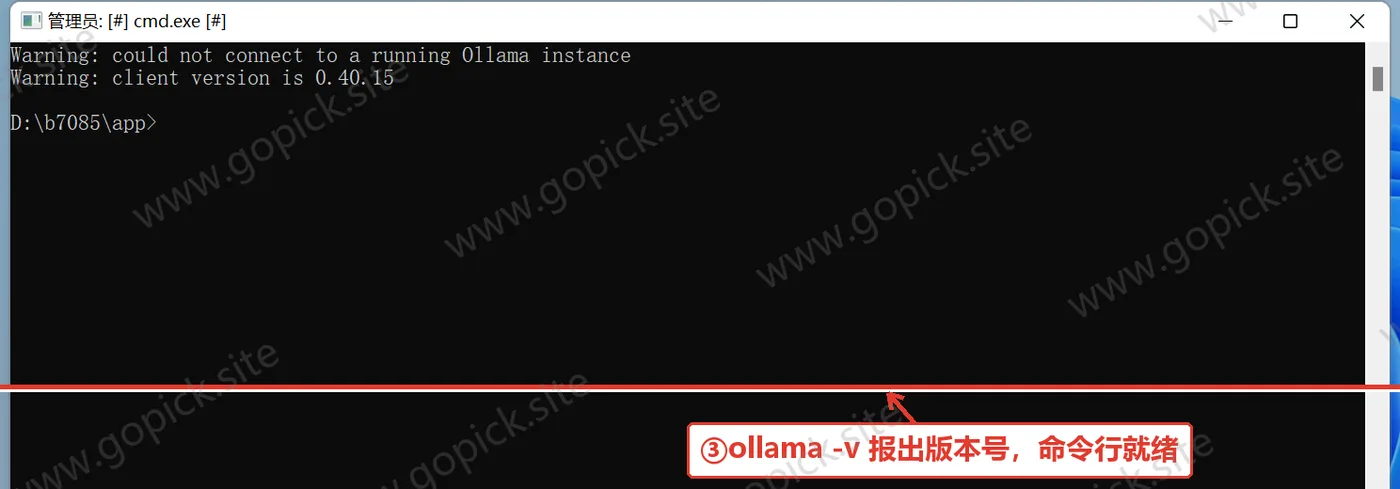
D:\Tools\ollama加进 PATH(「此电脑」右键 →「属性」→「高级系统设置」→「环境变量」→ 用户变量Path→「新建」→ 粘路径 → 三个「确定」),然后重开命令行,输入:
ollama -v输出 client version is 加版本号就装好了(实测 0.40.15;没起后台服务时它会附带一句「could not connect」,正常):
绿色版没有自动后台服务,跑模型前先执行 ollama serve(窗口别关),再开一个命令行窗口执行 ollama run 模型名。
把模型目录挪到别的盘#
这一步强烈建议做,装完立刻做。
模型默认存在 C:\Users\你的用户名\.ollama\models,一个 7B 模型 4-5GB,一个 30B 模型 20GB 起步,C 盘很快见底。
改法:设置系统环境变量 OLLAMA_MODELS,值填新路径,比如 D:\ollama\models。
「此电脑」右键 →「属性」→「高级系统设置」→「环境变量」→ 用户变量里「新建」,变量名 OLLAMA_MODELS,变量值填路径。
改完重启托盘里的 Ollama(右键图标退出,再从开始菜单打开)。已经下过的模型要手动搬到新目录,否则会重新下载一遍。
换个端口(可选)#
默认监听 127.0.0.1:11434。这个端口被别的程序占了的话,设环境变量 OLLAMA_HOST 改成 127.0.0.1:11435。
四、费用与授权#
Ollama 是 MIT 协议的开源软件,免费,没有账号体系。
不注册、不登录、不联网验证、没有用量限制、不收集对话内容。装完断网也能跑——本地模型下载完之后,整个使用过程完全离线。
模型本身也是免费的。 它拉的都是开源权重模型,遵循各自的开放许可(Apache 2.0、MIT、Llama 社区协议等),个人和商用基本都不收费,个别协议对超大用户量有额外条款。
没有隐藏收费点。 官方不卖 API 额度、不做订阅制,代码在开源仓库里放着。
五、第一次用:拉一个模型,聊两句#
先拉个小模型试水#
别一上来就拉 30B 的。 先用小的验证环境通不通:
ollama run llama3.2:3b3B 参数,量化后 2GB 左右,第一次运行会先下载,网速正常几分钟。下载完自动进对话界面,直接打字提问。
看到 >>> 提示符就是进对话了。 输入 /bye 退出。
换个顺手的模型#
模型库里有几百个模型,常用的几个系列:
| 系列 | 特点 |
|---|---|
| llama | 通用能力均衡,生态最全 |
| qwen | 中文表现好,有 0.5B 到 200B 各档 |
| deepseek 系列 | 推理和代码强,有蒸馏小版本 |
| gemma | 体积小,2B 就能跑 |
| mistral | 小体积高效,欧洲系 |
在模型库页面找到想要的,复制页面上那条 ollama run 模型名 命令,粘到命令行执行即可。
选模型的唯一标准是显存:
| 显存 | 能舒服跑的参数量 |
|---|---|
| 8GB | 7B-8B(量化后 4-5GB) |
| 12GB | 14B |
| 16GB | 14B 有余量,部分 20B |
| 24GB | 32B |
| 无独显 / 核显 | 3B 以下,且慢 |
模型参数超过显存不会报错,它会自动把一部分放到内存里跑——速度会掉到每秒一两个字。
常用命令#
ollama list              # 看装了哪些模型,占多少空间
ollama ps                # 看当前哪个模型在内存里
ollama pull 模型名       # 只下载不运行
ollama rm 模型名         # 删掉模型,释放空间
ollama serve # 手动启动后台服务六、装完能干的几件事#
当离线问答用。 断网、飞机上、内网环境里都能问。3B 的模型写写邮件、改改措辞够用,复杂的推理不行。
批量处理文件。 模型提供 HTTP 接口(127.0.0.1:11434),能用脚本调用。几百份文档做摘要、分类、抽取字段,本地跑不花钱、不限次数,这是它比在线 API 最实在的优势。
接进各种客户端。 很多第三方 AI 客户端、编辑器插件、笔记软件支持自定义 API 地址,填上本地这个地址就能用本地模型。写代码的插件、Obsidian 的 AI 插件都这么接。
给别的程序当后端。 不少开源工具默认支持 Ollama 作为模型来源,填个地址就行,不用配 key。
试不同模型的差异。 同一个问题问五个模型,看它们各自怎么答。这件事在本地做成本为零,在线上要花五次额度。
配合前端界面。 命令行对话体验一般,装个支持 Ollama 的图形界面前端(如 Open WebUI)就有网页版的聊天界面,模型还是本地的。
七、几个会踩的坑#
「ollama run 报 connection refused。」
后台服务没起来。看托盘有没有羊驼图标,没有就从开始菜单启动。装完必须重启一次命令行,环境变量和 PATH 才生效。
「下载模型卡在 pulling,进度不动。」
网络问题,模型从官方仓库拉,国内速度不稳定。多等一会儿,断了会重试;反复失败就换时间段。已下载的部分会保留,重新执行同一条命令会续上。
「跑起来很慢,一秒一两个字。」
模型没跑到显卡上。执行 ollama ps,看 PROCESSOR 那一列——显示 100% CPU 就是没用上显卡。原因通常是驱动太旧、显存不够、或者显卡型号不支持。显存不够是最常见的,换个更小的模型立刻见效。
「提示 out of memory 或者程序直接退出。」
模型太大,显存和内存都装不下。换小一号的模型,或者选量化等级更高的版本(模型名后面带 q4 之类标记的)。
「C 盘莫名其妙少了几十 G。」
模型都存在默认目录里。这是最常见的问题,解决办法就是改 OLLAMA_MODELS 环境变量(见上文第三节)。已经下过的模型可以用 ollama list 看清单,搬完文件再改路径。
「中文回答夹英文,或者答非所问。」
模型本身的能力问题,不是配置错。小参数模型的中文能力普遍弱,换 qwen 系列这类中文语料占比高的模型,效果立竿见影。
「端口 11434 被占用。」
设 OLLAMA_HOST 环境变量换端口,重启服务。注意换了端口之后,所有连它的客户端都要跟着改地址。
先拉一个小模型跑起来,确认能对话了,再考虑换大的。